前几天被Sora抢了热搜的谷歌,又突然发了个“最强开源小模型”
又是没有任何预兆,谷歌又搞了个大新闻。
21日晚,谷歌宣布推出开源模型Gemma,走的是对标Meta的Llama的轻量、高效路线。
谷歌也是蛮有意思的,16号推出Gemini1.5被OpenAI的Sora截了胡,一点风头没抢到,这次学聪明了。
毕竟有消息称,本周内,Meta将发布Llama的升级版,谷歌算是抢跑,先发了个对标产品。
Gemma在拉丁语中意为“宝石”,本次发布了20亿和70亿两种参数规模的版本,旨在支持笔记本电脑、台式机、物联网设备、移动设备和云端各种平台使用。
其用意不言而喻,就是想在开源大模型这个赛道全方位对标甚至反超Meta。
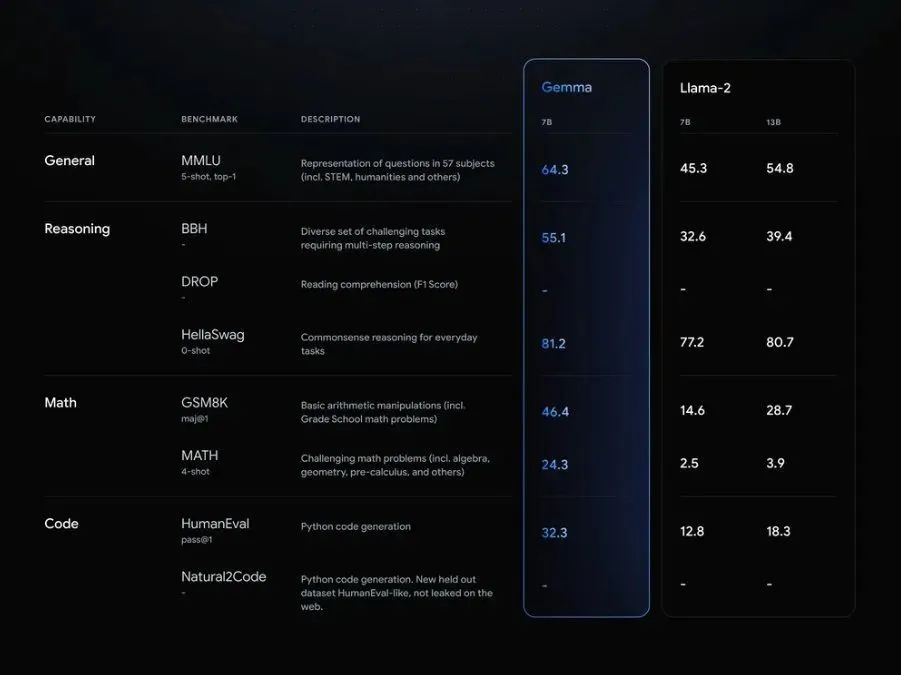
这就少不了一张跑分图,谷歌官方截图表示:我们在八项基准测试上大幅领先Llama-2。
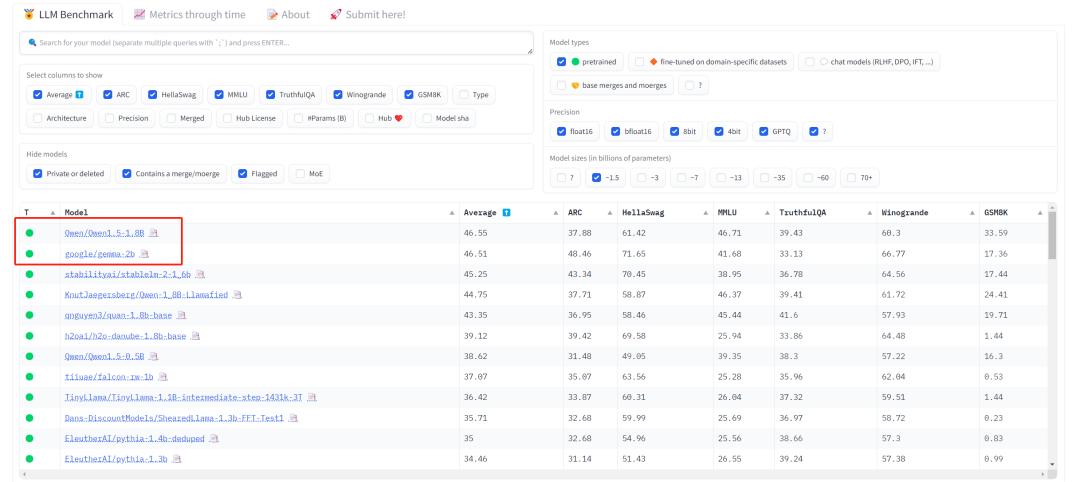
不过在HuggingFace的预训练大模型排行榜上,20亿参数的Gemma被同样是昨天发布的18亿参数级的通义千问挤下去了。
具体而言,Gemma采用与Gemini相同的技术和基础架构,基于英伟达GPU和谷歌云TPU等硬件平台进行优化,两种参数规模模型都有预训练和指令微调的两个版本,以方便不同类型的开发者和商家使用。
但不同于Gemini,Gemma模型不是多模态的,也没有针对多语言任务进行训练,DeepMind产品总监表示,Gemma当前最擅长英语语言相关任务,并且 “正在努力满足英语之外的市场。”
不过它同样使用了和Llama及Gemini一样的分词器,并且它的词汇表达到256K,这意味着Gemma可以很快学会使用其他语言。
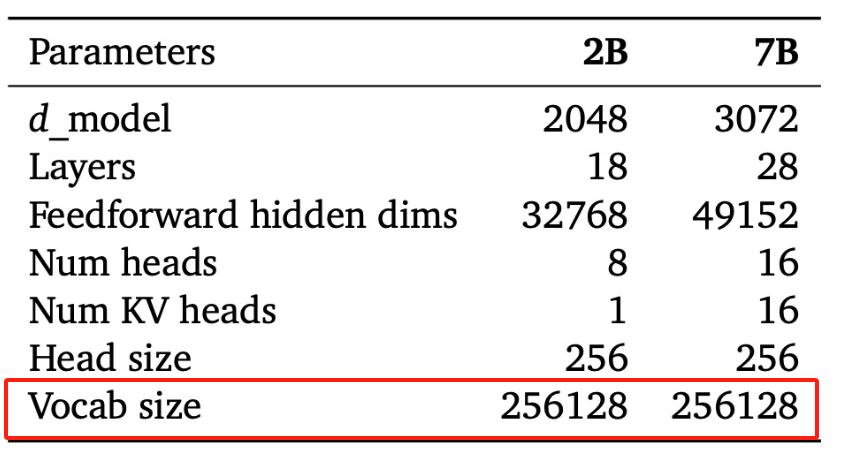
简单理解,大模型理解用户提问是将文本转化为数字之后再进行推理的,词汇表就类似它的字典,其规模越大,对于复杂句式和生僻字词的理解就越强,同样也就能够更快理解其它语言。
另一个值得关注的点是,Gemma从最开始的设计和训练之时,就非常注重安全性,这意味着它非常适合部署在本地使用。
例如谷歌使用Google Cloud数据丢失防护 (DLP) 工具,从训练集中自动过滤掉隐私信息和敏感数据。该工具根据隐私数据的类别(例如姓名、电子邮件等)输出三个严重级别。
据谷歌发布的技术报告显示,最为敏感的信息几乎完全不会被储存,潜在隐私数据会有部分储存。
同时,谷歌还利用来自人类反馈的强化学习(RLHF)对模型进行优化,这和Gemini类似,简单来说就是对真人反馈比较好的回答进行学习,以求在类似场景有更好的表现。
问题是,此前一直走闭源路线的谷歌,为何突然又走向了开源这条路?
这实际上也是当下绝大多数AI公司面临的问题:是和OpenAI一样把模型越做越大,最终实现和人类接近甚至击败人类的通用人工智能,还是尽快让更多人用上,大家一起探索可能性?
有AI研究员做过一笔测算,GPT-3.5的API价格几乎是开源模型Llama2推理成本的3-4倍,更别提GPT-4了。
正是由于GPT的过于强大,导致绝大多数情况下使用GPT就像是开兰博基尼送外卖,成本过于高昂。
这不光是对提供模型的公司来说负担巨大,对于使用者来说也是同理。
初创公司Summarize.tech就是个活生生的案例。它的业务是提供总结音视频内容的工具,拥有约20万月活用户,早期曾使用GPT-3.5来支持其服务。
后来,该企业试着将底层大模型更换成开源的Mistral-7B-Instruct,发现用户并没有感知到差异,但每月的推理成本却从2000美元降低至不到1000美元。
另一方面,超大参数量还往往带来服务器负载不足的问题。
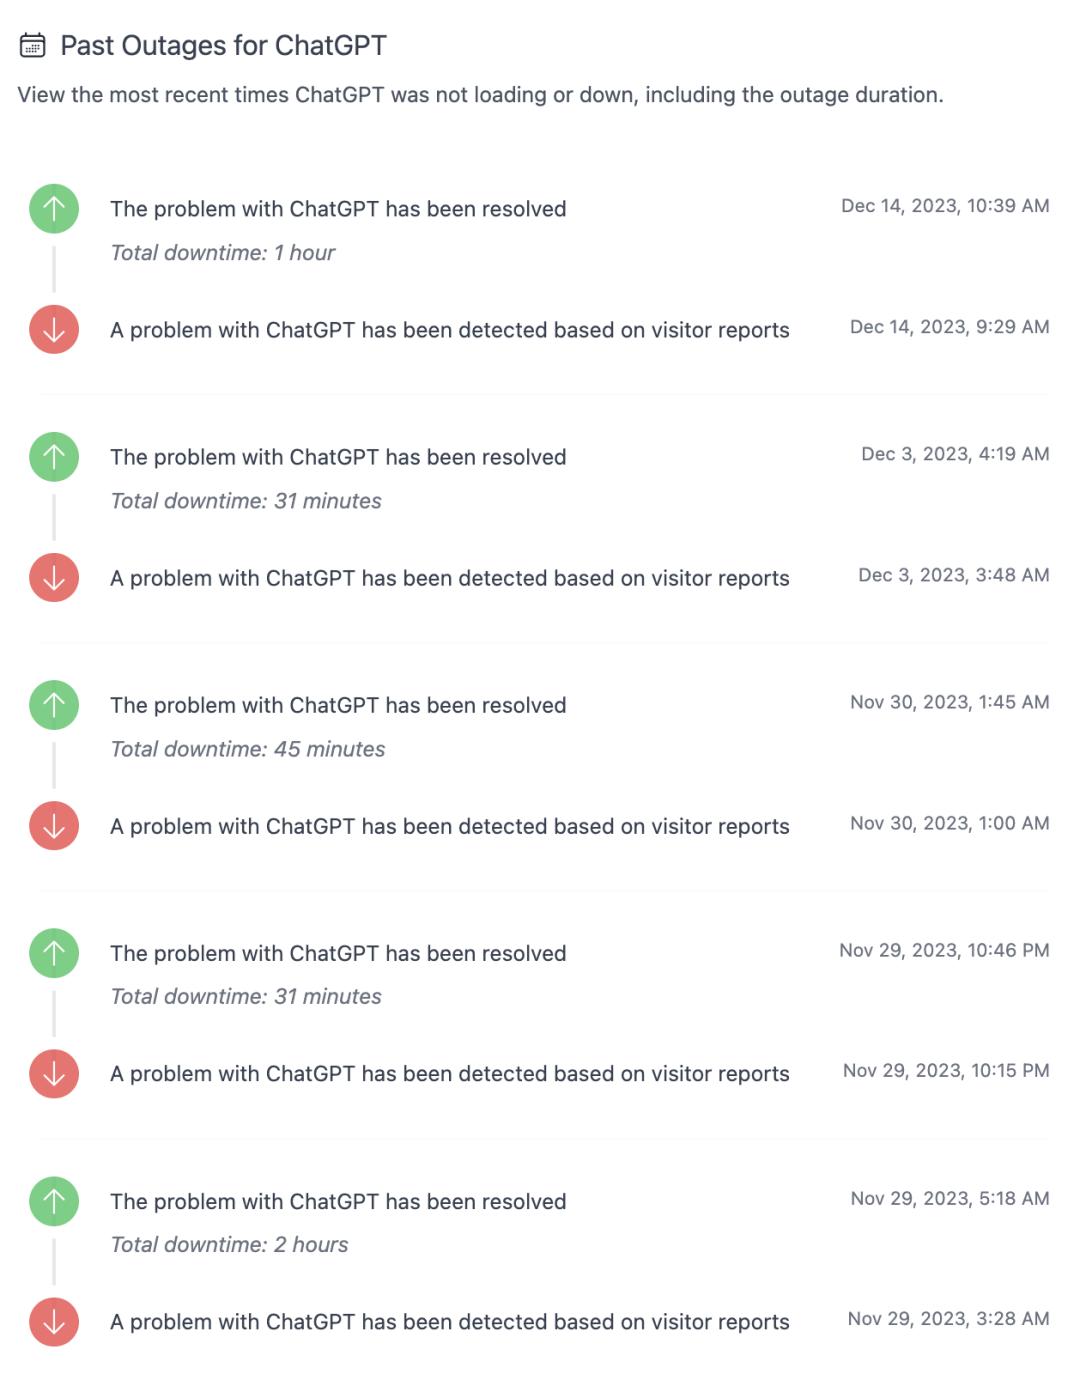
据数据监测网站Down for Everyone or Just Me的记录,从今年11月底到12月中旬,ChatGPT已经宕机5次。
大模型加上大访问量,对算力的需求是个无底洞,据安信证券测算,目前ChatGPT每天所需的算力约50EFLOPs,所需服务器约1万台。
据研究机构Epoch AI统计,训练尖端模型所需的算力每6到10个月就会翻一番。
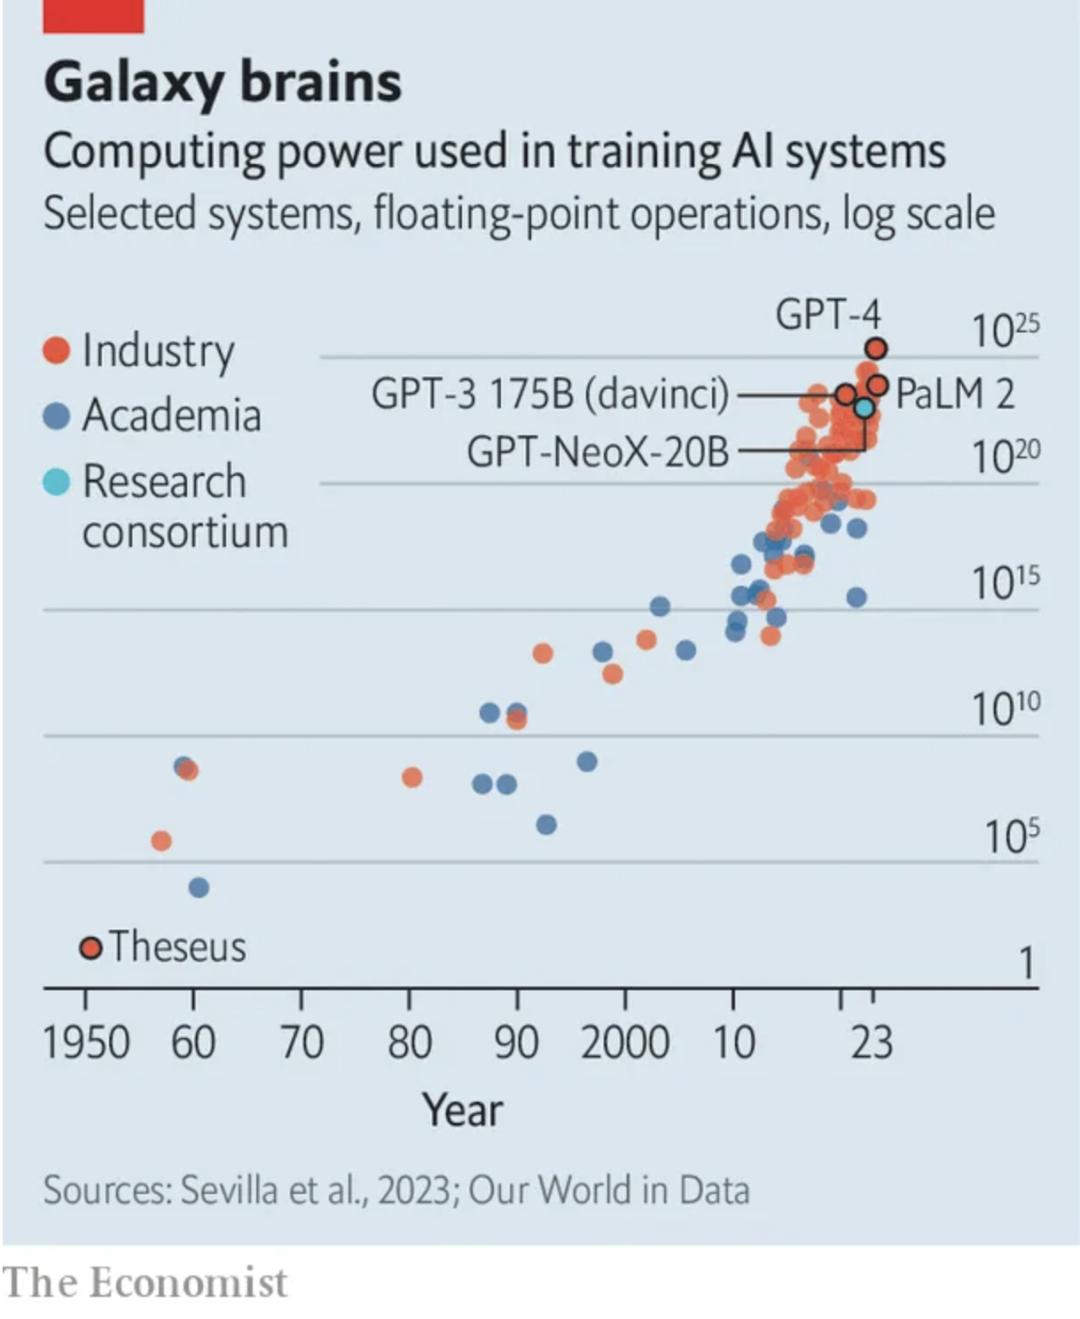
经济学人杂志在这个趋势上进行了推算,如果“10个月翻一番”的理论站得住脚,那到2026年训练一个顶尖模型的成本要超过10亿美元。
推理成本加上服务器部署成本,纵使财大气粗如谷歌,也不得不想点别的办法。
更别说在大模型这块,想要超越OpenAI实在难上加难。
这种成本上的巨大负担,成为了科技公司们另寻它路的首要原因,就像阿尔特曼在今年4月份他在MIT的一次演讲中说:
“我们已经到了大模型时代的尽头,是时候想点其他的办法来提升模型性能了。”
比如说,开源小模型。
接下来,就看Meta怎么接招了。
本文来自微信公众号“新硅NewGeek”(ID:XinguiNewgeek),作者:张泽一,编辑:呆萝卜,视觉设计:疏睿,36氪经授权发布。
















